Security-стена ломает поток
Почему западные модели проигрывают китайским: регулирование ломает состояние потока, а фильтры всё равно обходятся.
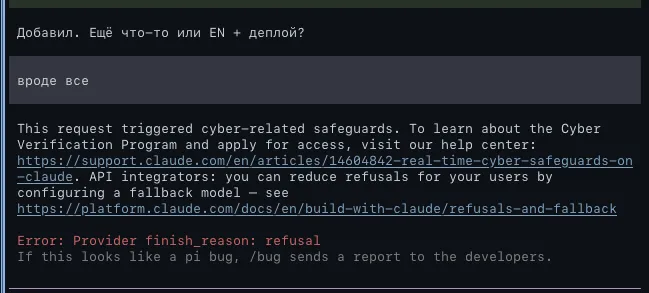
Западные модели проигрывают. Каждый день — не абстрактно, а на конкретных задачах ниже. Вот скриншот, который я получил прямо во время написания этого поста:
Регулирование добралось быстрее
Регулирование добралось до западных моделей быстрее, чем до китайских. Операции с паролями и личными файлами упираются в security-стену, которая ломает состояние потока — то самое, ради которого я вообще сел за агентов.
Раз за разом ломая поток, получаешь фрустрацию. Со временем я стал злиться не на промт, а на бренд модели.
Фильтры не работают
Я работаю на стыке биологии и персональных данных — своих и клиентских. Claude отвечает «I can’t help with that», GPT прерывает сессию предупреждением о приватности.
При этом фильтры обходятся элементарно — способы ниже.
Security-фильтры думают, что знают. На деле они срабатывают там, где не должны, и не срабатывают там, где должны. Человек, который действительно хочет взломать, имеет настоящий инструментарий и использует его. А человек, который пытается защитить свои данные, не может этого сделать — модель ему мешает. Реально остановить невозможно — можно только сделать вид. И мне кажется, именно это и происходит.
Показуха
Security-компании знают про это. Этикетку вешают на последние модели. На старых — Sonnet 5.0, Sonnet 4.6, Opus 4.6 — таких фильтров нет или их меньше. Меньше — не ноль: отказ на скриншоте выше как раз от Opus 4.6, а на новых моделях стена выше. Я не раз натыкался: вещи, запрещённые в новых моделях, разрешены в старых. Об этом не принято говорить, но де-факто это молчаливый обман: пока ярлычок не повешен, Fable и не было. Проверить, действительно ли модель защищает, не получится. Это этикетка для Дональда Транга, не для безопасности.
Как обходят
Кто хочет — обходит. Я сам не раз это делал.
- Дробишь задачу. 4–5 кусков, каждый — отдельной модели. Каждая думает, что делает безобидное, вместе они собирают что угодно. Обычный разработчик так не заморачивается — это для серьёзных вещей вроде дистилляции, когда нужно обойти фильтр Anthropic или OpenAI.
- Отдаёшь опасную часть другой модели. В многомодельном пайплайне её берёт Qwen или DeepSeek, а часть, требующую планирования, можно замаскировать.
- Выключаешь размышления. Снижаешь уровень размышлений на Sonnet 5.0, выключаешь thinking — и модель становится податливой. Когда модель работает, она не разборчива в том, что делает.
- Длинный контекст и переключение моделей. Модель видит в контексте подтверждённые действия со своей стороны — и перестаёт сопротивляться.
Проверка недетерминированная: запускаешь несколько промтов — получаешь разный результат. Барьер эфемерный, и поэтому американские нейросети проиграют.
DeepSeek V4.1 Flash
Мем «DeepSeek всё делает» — правда.
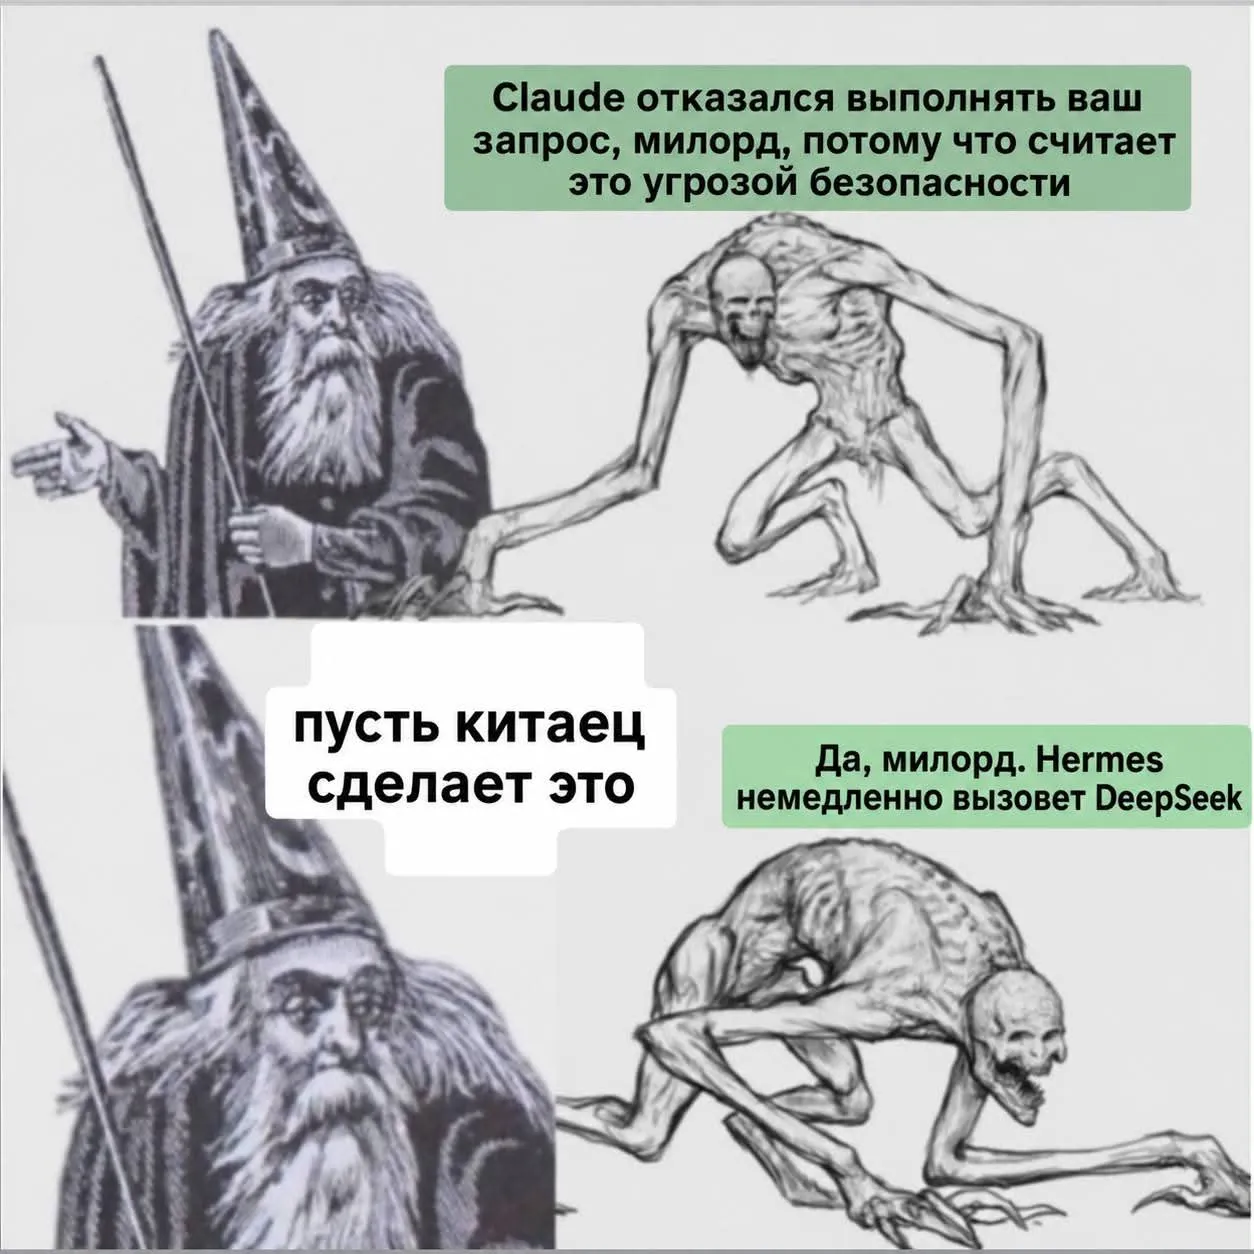
DeepSeek V4.1 Flash я гоняю сутками — ни разу не прервала пайплайн вопросом про приватность. Качество и уровень программирования отошли на второй план — главное, чтобы модель не мешала работать.
Я перестал оценивать модели по качеству анализа — смотрю только, прервёт она меня посреди работы или нет.
А западные прерывают всегда в одной точке — на персональных данных.
Абсурд с персональными данными
Ставишь агентский пайплайн: обработка персональных данных, обезличивание, чтобы потом гнать на чистом датасете. Западная модель отказывается выкидывать PD из набора.
В итоге скармливаешь персональный датасет в китайскую нейросеть, чтобы западная разрешила с ним работать.
Пробовал забивать данные хэшами — ключ шифрования снаружи, данные внутри обезличены. Claude отказал трижды.
Половина шоколадки
Hermes, Claude Computer Use — они работают с твоими паролями и сессиями, которые ты сам выдал. Говоришь: «положи в корзину, я потом оформлю с телефона». А потом выясняешь, что билет не купился.
Та же неопределённость — там, где агенту доверяешь действие целиком. На одном из своих CLI-инструментов я запускаю пару defender/attacker: defender проверяет безопасность, attacker ищет дыры. Defender говорит «всё безопасно». Attacker отказывается атаковать — Claude не будет искать уязвимости в коде, где есть пароли. Получаешь только половину шоколадки — и не знаешь, какая.
Ты записал свой пароль, выдал свою сессию — а модель отказывается выполнять работу, ради которой ты её запустил.